




合成受访者 vs. 真实消费者:区别在哪?各自什么时候用?

 63
合成受访者(Synthetic)vs. 真实消费者
在早期市场调研中,比如筛选创意、打磨问卷,合成受访者在速度和成本上优势明显;但在高风险的验证、需求测量、捕捉真实生活体验这些环节,都替代不了真实消费者。因此,最佳做法是:用合成方法做前期探索,用真实消费者来拍板那些影响重大的商业决策。
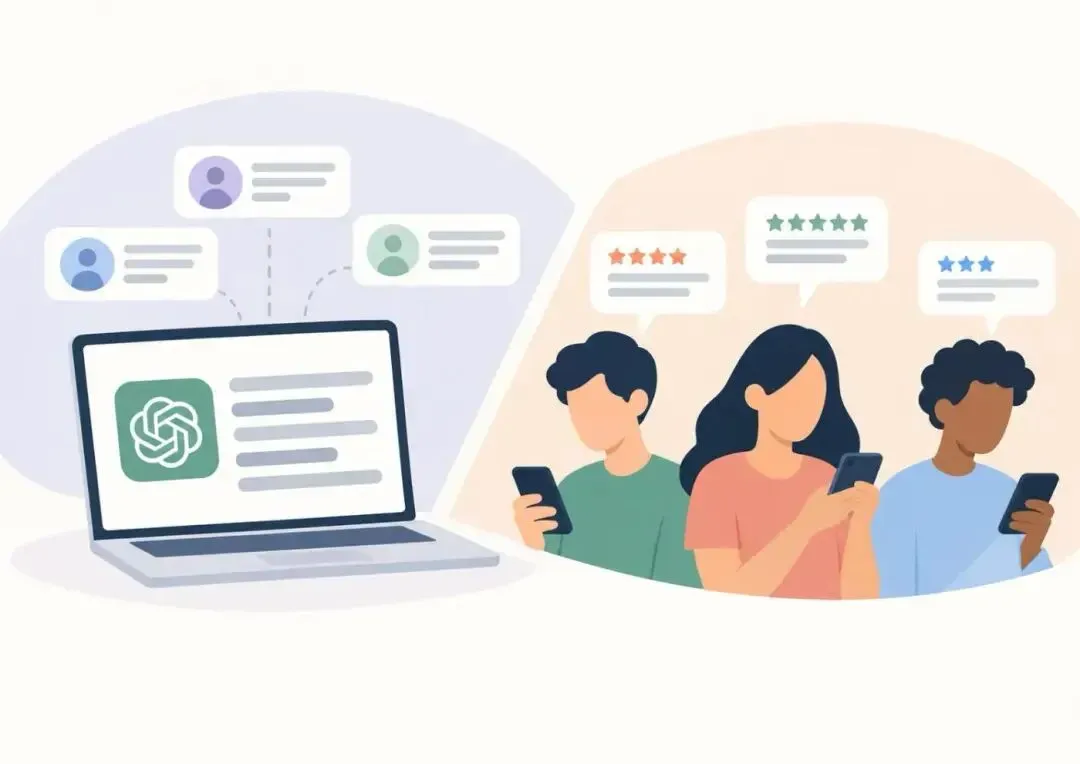
快速总结: 合成受访者是由AI生成的调研参与者,擅长快速探索想法、预判用户的反对意见、打磨问卷问题,以及把一长串概念精简成一份短名单。
但当你需要验证需求、测量价格敏感度、理解真实生活体验、在两个设计之间做难分高下的取舍,或者要为产品、品牌、营销活动投入预算时,仍然离不开真实消费者。
什么是合成受访者?
合成消费者调研(synthetic consumer research)的吸引力很难忽视。你向大语言模型(LLM)描述目标客户,把产品概念展示给这位"模拟客户",几秒钟就能拿到一份详细反馈。
传统市场调研项目还没启动,一个 synthetic panel(合成样本组)可能已经把新包装、公司名、广告创意或定价页面过了一遍。
这种速度很有价值,但也带来一个特定的诱惑:把"听起来像客户说的话"当成"来自客户的证据"。合成受访者根据训练数据、你的prompt,以及系统所依托的真实数据,生成看似合理的语言。真实的人恰恰相反:他们有真实的生活经验和实际购买行为,但也会看错题、出于礼貌作答,而且说的和做的常常不一致。
所以,合成受访者 vs. 真实消费者反馈之争,并不是"高效的 AI"对"乱糟糟的人类"。用错了地方,两者都会误导你。
真正有用的问题是:在决策的每个阶段,你需要什么样的证据。合成调研的价值在早期,那时改主意的成本很低;越接近生产、投放预算、定价和上市,真实消费者调研就越重要。
测试 1:两条卖点,只差一个词
一个狗零食品牌正在斟酌一款冻干牛肝零食的主打卖点(hero claim)该怎么写:
A. Single ingredient — just beef liver(单一成分:只有牛肝)
B. Limited ingredient — beef liver only(有限成分:仅含牛肝)
同一款产品,同一个事实,只差一个词。
我们问了 15 位美国狗主人:哪条卖点让你对这款零食的品质更有信心?同时请ChatGPT 和 Perplexity 预测这 15 个人会怎么投票。(两轮测试都在 2026 年 9 月进行,ChatGPT 使用 GPT-5.6 Luna,Perplexity 使用其默认模型。)
📊 调研示例:Dog treat hero claim test(狗零食主打卖点测试),15 位美国狗主人
问卷链接:https://app.pickfu.com/results/mUnnOG7Q1J
狗主人们以15 比0 一边倒地选择了 "single ingredient",理由也说得很清楚:
"'Limited' 听起来像是量不够。"
"A 明显好得多。明明只有一种成分,为什么要用 'limited'?这个词本身就暗示了相反的意思。"
"有点让人困惑,甚至有误导的嫌疑,因为 'limited ingredient' 会让我以为不止一种成分。"
这是个简单案例:选项是文字,差别只有一个词,考的是理解而不是口味,而且答案全票一致。
这正是模型最有可能答对的条件,结果两个模型也确实都答对了。它们都选了 "single ingredient":ChatGPT 的理由和受访者一样("limited" 暗示不止一种成分),Perplexity 则是觉得它听起来更简单、更纯粹。
错在差距上:ChatGPT 预测 9 比 6,Perplexity 预测 12 比 3,而真实狗主人是 15 比 0。如果只是在两条卖点里二选一,选对哪个才是关键,用任何一个模型都能帮你省下一次调研。
合成筛选的价值一句话就能说清:不是说模拟反馈和真实反馈一样好,而是有些问题暂时还用不着真实反馈。
测试 2:六条标语,没有明显赢家
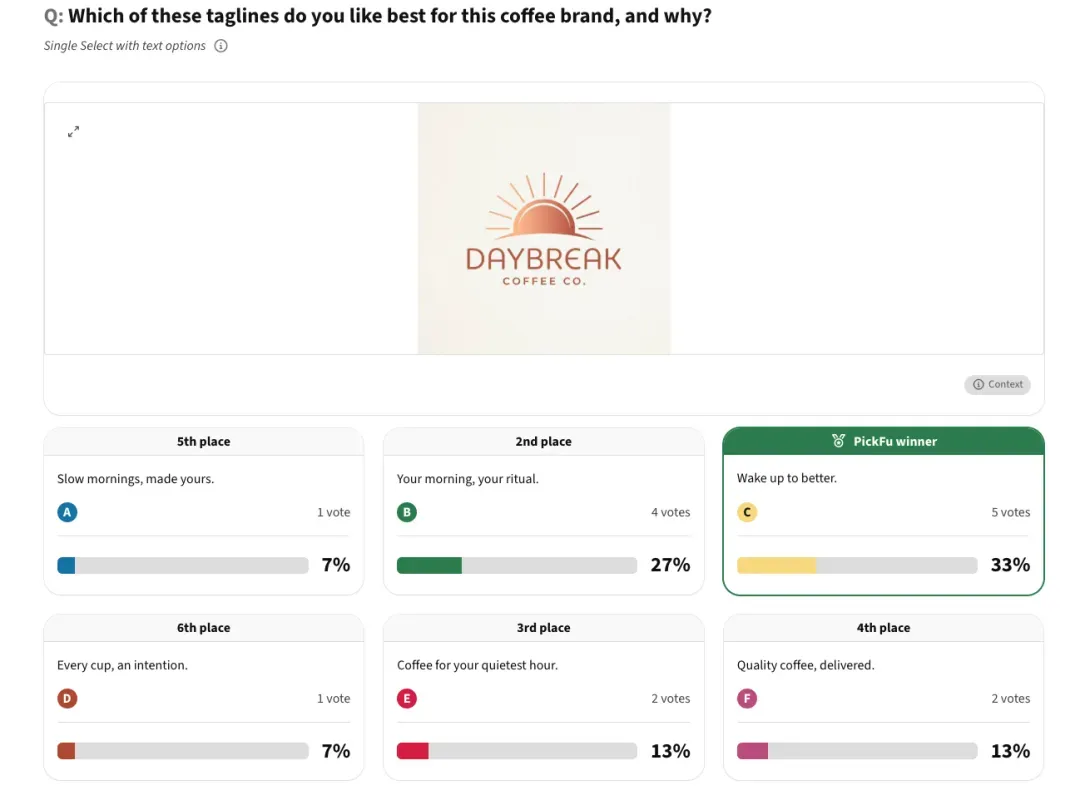
Daybreak Coffee Co. 是我们用来做测试的虚构品牌。在这个场景里,Daybreak正在为一款精品咖啡订阅服务重写品牌标语(tagline),手上有 5 个候选,和现用标语放在一起测试:
A. Slow mornings, made yours.(慢享清晨,由你定义)
B. Your morning, your ritual.(你的清晨,你的仪式)
C. Wake up to better.(醒来,遇见更好)
D. Every cup, an intention.(每一杯,都有心意)
E. Coffee for your quietest hour.(献给你最安静时光的咖啡)
F. Quality coffee, delivered.(好咖啡,送到家)(现用标语)
设置相同:15位美国咖啡饮用者,定向女性;两个模型拿到的也是同样的六个选项。
📊 调研示例:Daybreak tagline resonance(Daybreak 标语共鸣度测试),15 位美国咖啡饮用者
问卷案例:https://app.pickfu.com/results/zBgO6MOnLk
结果显示:
"Wake up to better" 以 33% 胜出,15 票里拿了 5 票。"Your morning, your ritual" 拿到 27%。其余四条分别是 13%、13%、7%、7%。
现用标语拿到 13%,并列第三,排在五条新候选中的两条前面。
有一位受访者质疑了半张清单背后的前提:"带'早晨'的那几条,感觉像是在限制只能早上喝咖啡,挺奇怪的。"
另一位受访者解释完自己的选择后,写了一句她觉得比清单上任何一条都好的标语:"我觉得像 'Rise to better' 这样的会更好,还能顺便玩一下'旭日东升'的双关。"
模型的预测:ChatGPT认为 "Slow mornings, made yours" 以 5 票胜出,把 "Wake up to better" 排在第五、只给了 1 票,而真实受访者的结果正好把这两条倒了过来。
ChatGPT对其余四条标语的票数预测和真实结果完全一致,但推理恰恰建立在那位受访者所反驳的假设上,称赞这条标语"承诺了一个宁静、更美好的早晨"。两轮测试说明了什么
让AI模型挑赢家,就一定会挑出一个赢家。在狗零食卖点上,这正是你想要的:问题本来就有答案,模型找到了它,帮你省了一次调研。
但在标语测试上,同样的行为就成了问题,因为这里本来就没有赢家可找。
15个人给出的是 33% 的相对多数和六方分散的结果,现用标语还胜过了两条新候选;最有价值的两条回答根本不在投票里:一条质疑了brief本身,一条直接重写了标语。两个模型都没发现这些,彼此的结论也不一致。
ChatGPT选出的赢家,是真实用户排在靠后的一条。Perplexity 把亚军捧成了冠军,又把胜过两条新候选的现用标语判了"出局"。
所以,真正有用的分界线不是"合成 vs. 人类",而是"已有定论 vs. 尚有争议"。合成受访者擅长确认已经明确的事,却不擅长告诉你"还没有定论",而且两种情况下它们的语气听起来一模一样。这也是为什么PickFu自己的合成测试版会把选项分成较强的一半和较弱的一半,而不是直接选出唯一的赢家。