6万SKU的效率革命,增长不再靠堆人
 322
今年,卖家的商品页可能还没有被消费者打开,就已经输掉了一次竞争。
一个美国消费者在Google AI Mode里输入:“帮我找一套适合小阳台、可以淋雨、500美元以内的户外桌椅。”AI会读取不同商家的尺寸、材质、价格、库存、配送和评价,直接给出几个选项。部分商品甚至可以在对话中完成结账,不必再进入品牌官网。
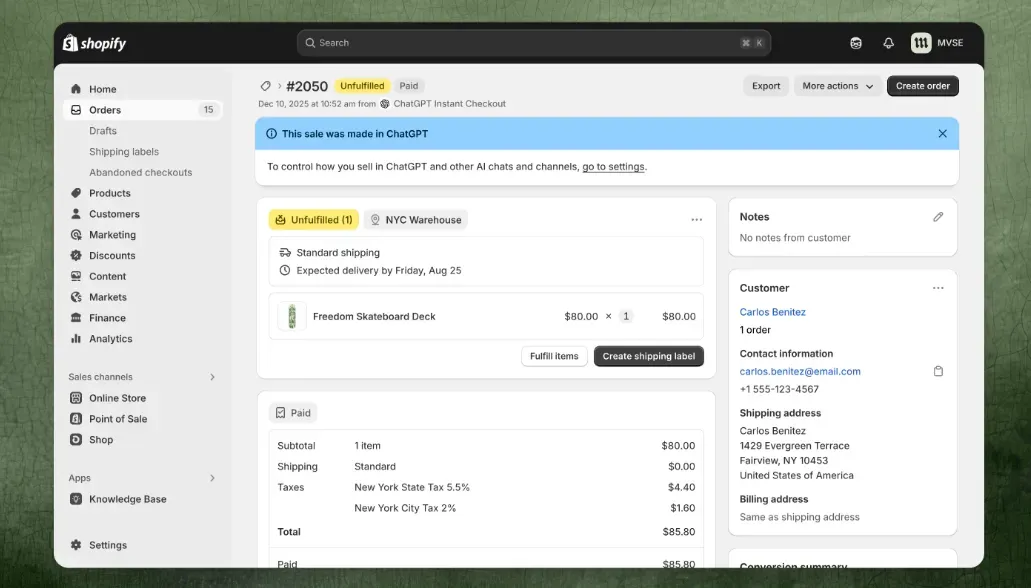
这不是未来设想。Google正在通过Universal Commerce Protocol(UCP)打通AI搜索与交易,目前已让部分美国消费者在AI Mode和Gemini中直接购买Etsy、Wayfair的商品,Shopify、Target和Walmart等也在接入。
Shopify则开放了Catalog API,让AI能够检索平台上的海量商品;OpenAI推出的Agentic Commerce Protocol(ACP),也开始通过结构化商品Feed读取标题、描述、图片、价格、库存、变体、配送与退货信息。
过去,卖家争的是搜索结果第几位;现在,AI可能先替消费者删掉大部分选项。
新的问题是:当消费者不再逐页浏览,你的商品凭什么进入AI给出的三五个答案?
在卧兔主办的大会上,遨森电商独立站运营总监秦晓臻分享的6万SKU实践,恰好提供了一个理解新规则的入口。
因为AI购物竞争的第一步,不是再多做几张图,而是让企业的商品数据、内容证据和用户反馈真正连起来。
商品页正在失去“第一解释权”
AI先读数据,再决定消费者有没有机会看到你
AI先读数据,再决定消费者有没有机会看到你
传统电商的基本逻辑,是先把用户带到页面,再通过主图、标题、详情和评价完成转化。
AI购物把顺序改了。机器会先读取商品信息,理解消费者的自然语言需求,再判断哪些产品值得进入候选清单。消费者看到品牌之前,AI已经进行了一轮筛选。
这带来三个容易被卖家忽略的变化。
▶ 第一,商品数据不完整,会直接损失新的流量入口。
“高品质户外桌椅”对AI几乎没有判断价值。“桌面尺寸120×70厘米、铝制框架、可容纳4人、适合6平方米以上阳台、提供防水罩、配送到美国本土”才是可以被匹配的数据。
▶ 第二,不同渠道信息冲突,会降低机器的判断信心。
独立站写承重150公斤,Amazon写120公斤;红人视频说安装需要两个人,商品页却宣称一人十分钟完成。消费者可能只看到其中一个版本,AI却可能同时读到多个版本。
▶第三,AI推荐不只依赖品牌自己的描述。
用户评价、红人测评、媒体内容、论坛讨论和退货政策,都会成为外部证据。品牌说自己“耐用”只是主张,创作者展示产品经历雨天、连续使用和真实安装,才是验证。
卖家因此需要同时完成两件事:让机器准确理解商品,让市场提供足够证据证明商品。
数据决定效率
遨森6万SKU背后,是统一商品信息工作流
遨森主营家居、户外、母婴、宠物和办公等品类。据秦晓臻介绍,公司拥有约6万SKU,业务覆盖多个欧美市场,并布局30多个海外仓。
同一件商品进入美国、英国、德国和法国,需要不同语言与表达;进入Amazon、eBay和独立站,又要适配不同格式。遨森单个国家站点可能有5000至8000个SKU,客服不可能记住所有尺寸、物流和安装信息。
如果继续依靠人工搬运资料,企业面对的不只是效率低,而是不同市场的产品信息会越来越不一致。
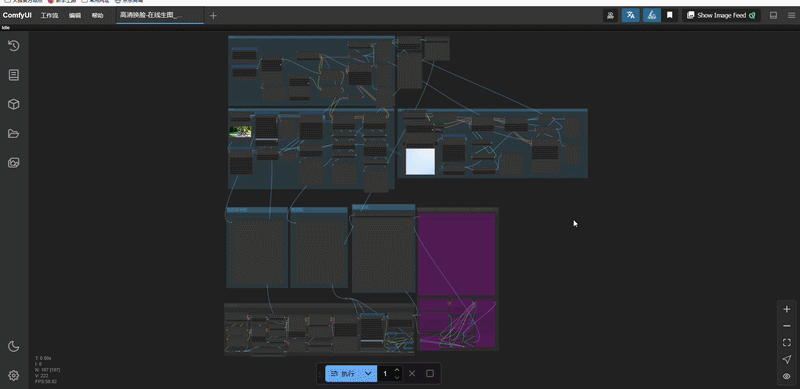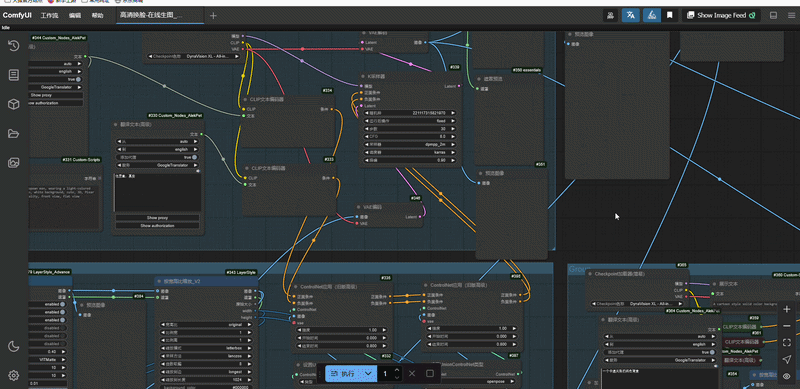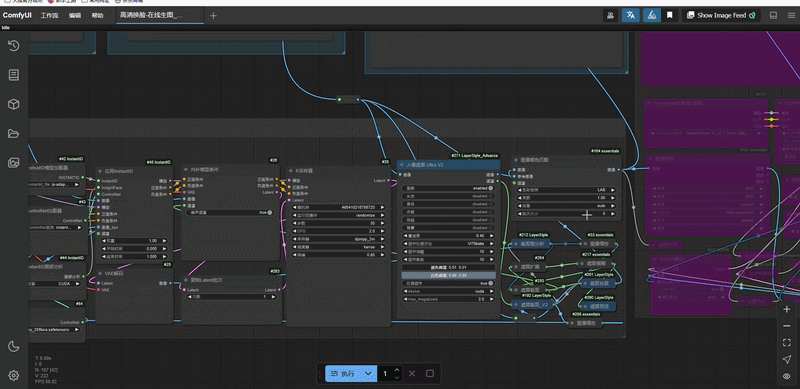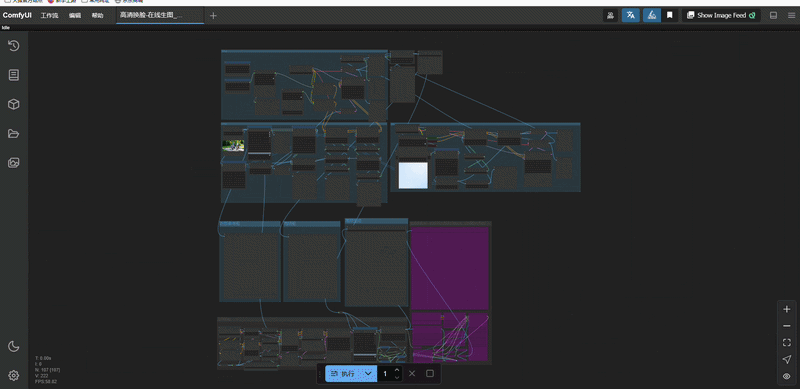
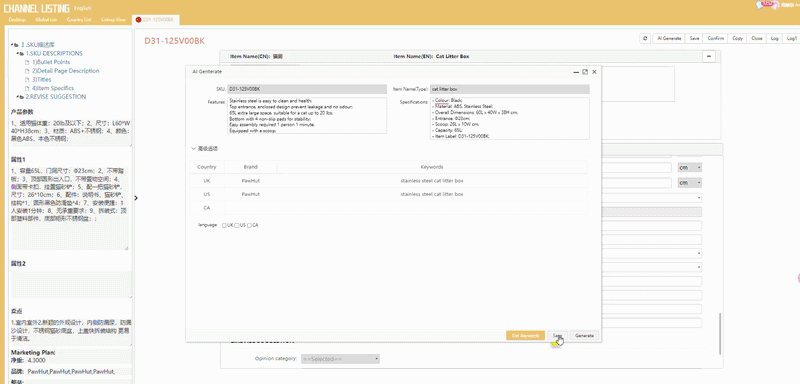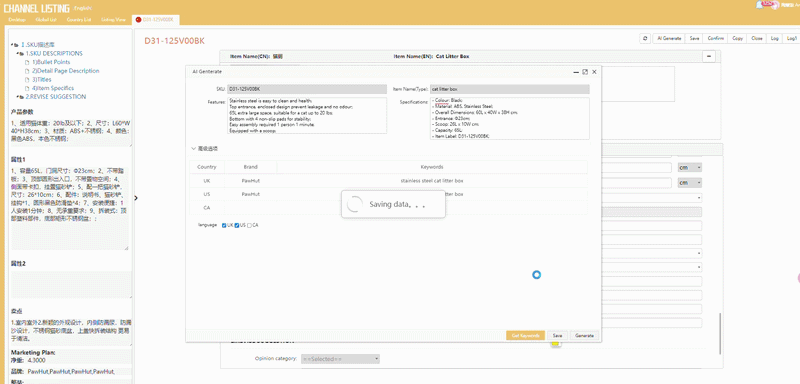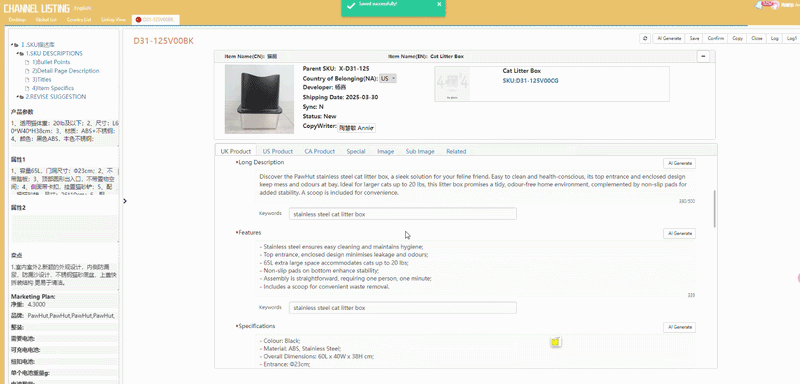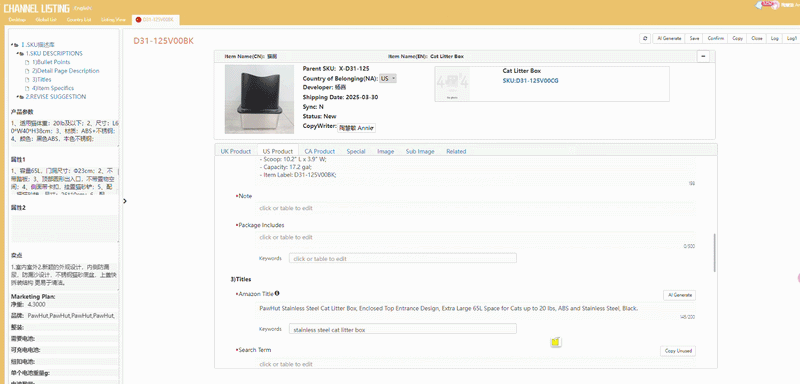
遨森内部的Channel Listing系统先维护中文产品资料,再按照国家、语言和平台规则生成对应版本。过去约十人的团队需要一到两周完成的一批新品,现在可以压缩到一两天。
客服系统也使用同一类思路:先识别消费者是询问选型、物流、质量还是售后,再调用产品资料和SOP生成答案,人工客服负责审核和处理例外。
这套实践最值得卖家学习的,不是“用AI写Listing”,而是建立商品信息的唯一可信来源。
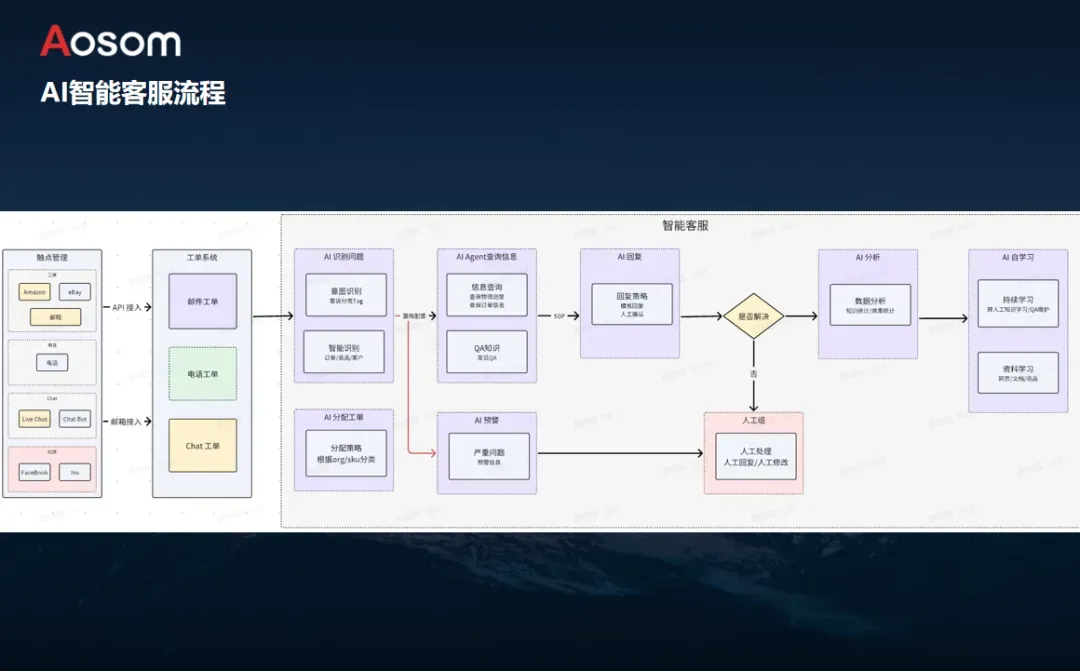
如果尺寸在Excel里、安装说明在PDF里、退货政策在客服脑子里、红人反馈留在聊天记录里,再强的模型也只能给出零散甚至矛盾的答案。
秦晓臻提到,遨森业务仍保持两位数增长,人员增长却已经放缓。其背后的逻辑是:AI不再服务某个员工,而是让同一套数据被运营、设计、客服和不同市场共同调用。
卖家要补的四层结构
从商品库到红人证据库,缺一层都可能掉出推荐
面对AI购物的新入口,卖家不必一开始就开发复杂智能体。更现实的做法,是先补齐四层基础。
▶ 第一层:建立“单一商品真相”
先为核心SKU建立统一的结构化资料,而不是继续维护互相独立的渠道文案。
除了标题、描述、图片和价格,至少还应统一:
▪️ 尺寸、材质、颜色、适用人群与使用空间;
▪️ 变体之间的真实差别,而不是只换一个SKU编码;
▪️ 库存、配送范围、时效、安装条件和退货政策;
▪️ 不同国家的合规信息、单位、插头或使用限制;
消费者最常问的问题及明确答案。这份资料应该成为独立站、平台Listing、客服知识库和红人Brief的共同源头。修改一次,相关渠道同步更新。
▶ 第二层:按“购买疑问”生产红人内容
很多品牌给创作者的Brief仍然是“展示外观、讲三个卖点、带上折扣码”。这种内容可以制造曝光,却很难补充购买证据。
更有效的方法,是先从客服、差评和退货原因中找出阻碍成交的问题,再让不同类型的创作者分别验证。
以户外家具为例,可以把内容拆成四类:
▪️ 空间验证:真实阳台能否放下,坐下后是否拥挤;
▪️ 安装验证:一个人还是两个人安装,需要多久,最容易装错哪里;
▪️ 耐用验证:雨天、暴晒或持续使用后的状态;
▪️ 生活验证:家庭聚餐、宠物共处、小户型收纳是否成立。
红人不再复述参数,而是替消费者完成购买前无法亲自进行的试用。
▶ 第三层:一条内容至少进入三个位置
红人内容发布以后,不应只留在创作者账号里。
品牌可以在合作前明确授权与素材规格,把一条有效内容拆进三个环节:社媒负责触达,广告负责放大,商品页负责转化。
视频中的高频问题和字幕文本,还可以进入FAQ、博客和客服知识库。例如,一条完整YouTube测评可以沉淀为:独立站产品页的真实体验视频、Amazon详情页的使用片段、TikTok或Reels短版素材,以及客服回答安装问题时可以调用的演示内容。
衡量项目时,也要增加“内容复用率”:发布的红人内容中,有多少进入了广告、商品页或品牌知识库。只有播放量,没有复用,项目结束后价值就停止了。
▶ 第四层:让评论区返回产品系统
红人评论区往往比一份调研报告更早暴露真实问题,但很多团队只回复评论,不整理信息。
可以把反馈固定分成五类:产品功能、尺寸适配、安装使用、物流售后、价格比较。每周把高频问题返回商品资料、客服SOP和下一轮创作者Brief。
如果“能否放进公寓阳台”连续出现,就补充尺寸示意和空间实拍;如果用户反复询问防水等级,就让下一位创作者做真实天气测试,而不是继续拍开箱。
这一步把红人营销从内容项目变成市场研究,让下一轮内容比上一轮更准确。
AI内容越多,红人越要精选
AI内容越多,品牌越需要本地验证网络
当AI可以快速生成脚本、图片和视频,品牌最容易犯的新错误,是用更高效率生产更多错误内容。同一份总部脚本翻译成十种语言,不等于完成十个市场的本地化;找一批粉丝量相似的达人,也不等于建立了可信推荐。
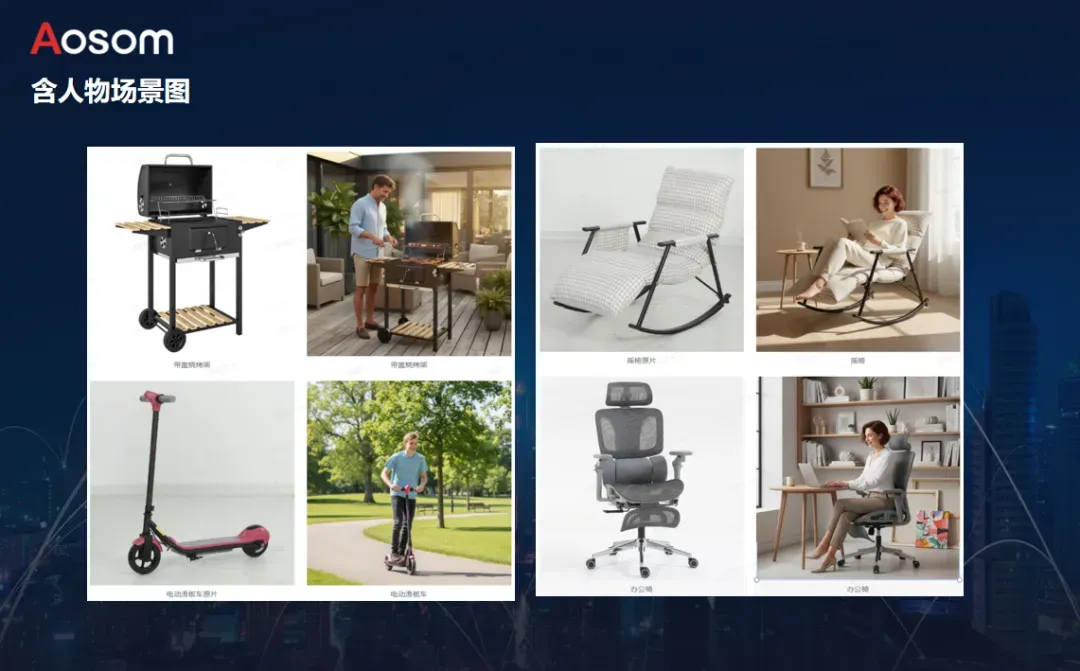
卧兔在项目中需要解决的,是三个更难标准化的问题。
▪️ 谁来验证。 根据国家、品类、受众和购买疑问选择创作者。安装复杂的家具,需要能够完整演示的家居创作者;涉及耐用性的户外产品,需要真实长期场景,而不是棚拍账号。
▪️ 验证什么。 Brief不从“必须念出的卖点”开始,而从“消费者为什么还不敢买”开始。一个创作者解决一个关键疑问,比十个人重复同一组参数更有价值。
▪️ 证据怎样留下。 合作前规划授权、比例、字幕和原始素材;发布后追踪评论与内容表现,把有效片段进入广告、商品页、搜索内容和下一轮策略。
这也是卧兔与简单达人采购的区别,我们不是把红人当作流量库存,而是把不同市场的创作者组织成品牌的外部验证网络。
对大型企业,这套网络可以接入内部商品知识库和AI工作流;对成长型卖家,它可以降低进入陌生市场时的寄样浪费和内容试错。
未来的流量公式已经变了
机器筛选、真人证明,系统沉淀有效证据
机器负责筛选,真人负责证明,系统负责把证据留下,过去的跨境流量公式更像是:关键词、广告出价和页面转化。
AI购物时代,它正在增加三个新的变量:结构化商品数据 × 外部可信证据 × 实时履约能力。
商品数据决定AI能不能准确理解;红人测评、评价和媒体内容决定产品值不值得被相信;库存、配送和退货能力决定AI推荐之后能否完成交易。这三个变量不是营销部门单独能够完成的。运营要维护商品数据,客服要回传高频问题,供应链要保证库存和时效,红人团队要生产可验证、可复用的本地内容。
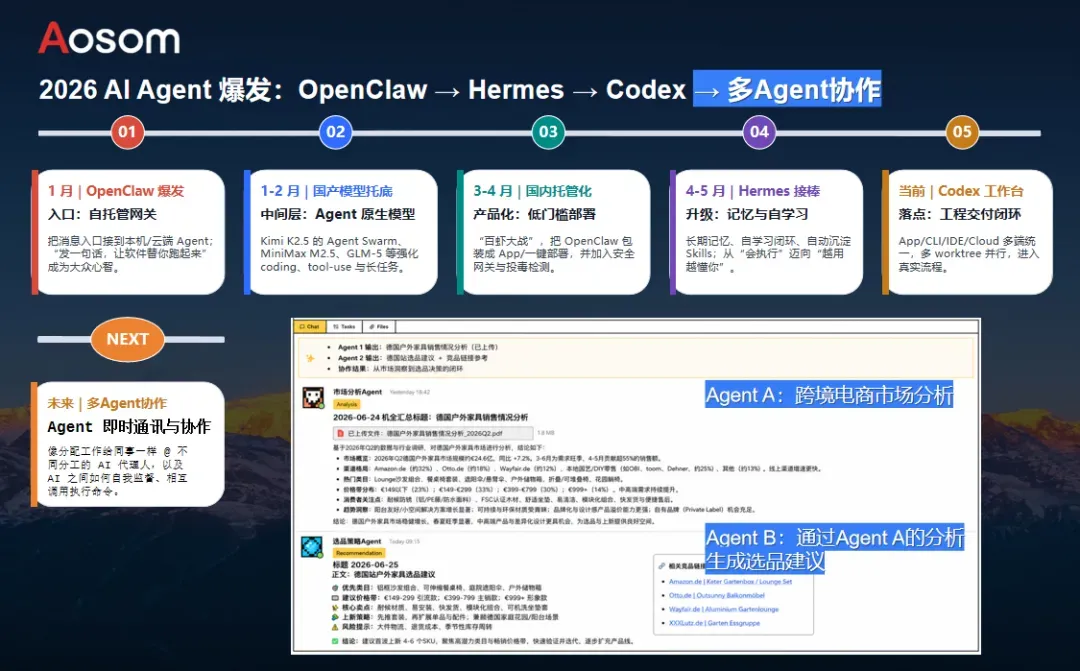
卖家可以先挑10个核心SKU做一次小规模测试:统一全部渠道的产品资料,为每个SKU列出三个主要购买疑问,分别找匹配创作者完成验证,再把表现最好的内容进入商品页和广告。30天后,比较客服重复问题、商品页转化、素材点击和内容复用率的变化,这比一开始就追求“全公司AI化”更容易获得真实结果。
秦晓臻的分享证明,AI已经能够把一批新品的上线周期从一两周压缩到一两天,把部分视频成本降到传统方式的1%以内,但效率只是起点,当消费者开始让AI替自己选商品,品牌真正要建立的,是一套同时服务机器理解和用户信任的内容系统。
AI负责让品牌说得更快、更广;本地创作者负责证明这些话为什么是真的;卧兔要做的,是让每一次证明都能进入下一次增长。
如果你的团队正在规划新市场,不妨把这篇文章转给运营、客服、品牌和供应链负责人,一起检查:我们的商品资料是否一致?红人内容是否解决购买疑问?每次合作结束后,品牌究竟留下了什么?