我把亚马逊选品流程重新做了一遍

 571


《全球电商市场报告—印尼篇》重磅发布!拆解2.8亿人口下的千亿美金增量机会
这篇文章不推荐具体产品,也不准备总结一套“照着做就能出爆款”的公式。我想分享的是,在复盘过几轮新品之后,我如何把原来依赖榜单、关键词和竞品销量的选品流程,重新拆成一条能够回到证据、也允许中途停止的开发路径。
这套流程目前仍在调整,未必适合所有团队。它更适合愿意改材料、结构、尺寸甚至重新打样的开发方式;如果公司以现货铺货和快速跟款为主,其中一些步骤可能显得太慢。
但我越来越确定一件事:新品最大的浪费,不是第一批货卖得慢,而是团队在一个未经验证的需求上,把选品、开模、备货、广告和运营连续做对了半年。
我现在使用的顺序是:站外找任务 → 识别补偿行为 → 抽象需求 → Amazon反查 → 供应侧验证 → 形成产品假设 → 小批量测品 → 决定放大或停止。
PART 1
为什么我要把“看站内数据”从第一步挪到后面?
过去做选品,我也习惯先看Amazon榜单、关键词搜索量、销量估算和评论数量。这些工具并没有错,问题在于我曾经让它们回答了一个不擅长回答的问题:用户还缺什么?
站内数据更擅长描述已经发生的交易。当一个产品形成稳定搜索词、成熟类目和清晰价格带时,说明需求已经被某种产品形态定义了。此时再进入,开发人员很容易围绕现有答案做微调:别人是两轴支架,我做三轴;别人填充5厘米,我加到7厘米;别人配两个绑带,我增加到三个。
这些改动有时有效,但它们往往没有重新回答“用户为什么需要这件东西”。大家使用相似的数据库和筛选条件,最后自然会看到相似的产品。
评论也不是完整需求。评论区记录的是已经购买某个解决方案的人,却看不到另外几类人:搜索后没有合适产品而离开的人、还在使用临时办法的人、觉得现有商品不值得购买的人,以及根本不知道该用什么产品名称搜索的人。
因此,我现在把Amazon放到第二阶段。它主要负责回答:
1. 围绕这项任务,市场上已经出现了哪些解法;
2. 价格、评分、评论和销量大致呈现什么结构;
3. 多个产品是否反复暴露同一个缺口;
4. 这个缺口是单个卖家的质量问题,还是现有方案的共同限制。
需求的起点则放到站外,因为人在论坛、短视频评论区、兴趣小组和生活内容里,通常不会按照Amazon类目名称描述问题。他们说的是“每次刹车狗窝都会往前滑”“支架晒一下午就掉了”“回家后整张垫子塞不进洗衣机”。这些话看起来零散,却比“pet car seat月搜索量多少”更接近任务本身。
PART 2
站外选品不是追热点,而是找用户正在怎样凑合
最开始做站外信息收集时,我也犯过一个错误:看到某个产品在TikTok频繁出现,就把出现次数当作需求强度。后来发现,社媒内容可能是广告、演示、猎奇传播、达人重复铺量,也可能只是用户在讨论一个有趣但不会购买的东西。
所以我不再先统计“出现了多少个产品”,而是先给线索分类:
明确求助:用户主动询问有没有办法解决;
重复抱怨:不同用户在相似场景遇到同类问题;
补偿行为:用户用毛巾、胶带、塑料袋或额外动作临时处理;
放弃行为:因为麻烦、清洁或安全顾虑而减少使用;
反方证据:有人认为现有办法已经足够,或者不愿为改进付费;
带货内容:只能证明产品被推广,不能单独证明自然需求。
这里最有价值的往往不是抱怨,而是补偿行为。
“这个产品不好用”只说明用户不满意;“我每次都要在座椅下面垫一条毛巾,再用安全带绕两圈固定”则暴露了产品需要替代的动作、用户已经承担的成本,以及潜在方案必须满足的限制。
PART 3
案例复盘:我会怎样研究“车载宠物窝”?
假设团队收到一个方向:美国宠物消费体量较大,是否可以开发车载宠物窝?
我不会先去1688找一款看起来不错的窝,也不会马上搜索“dog car bed”的头部销量,而是把它当成一条尚未成立的假设。
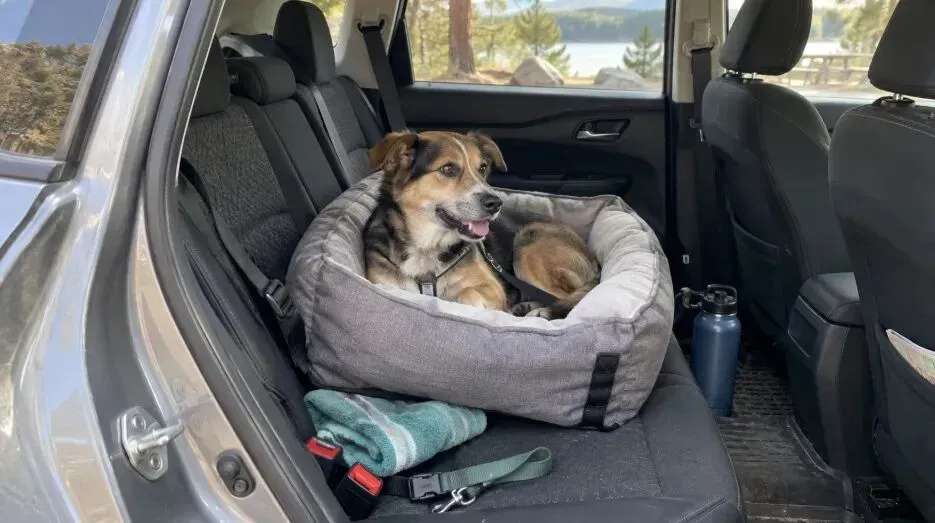
图1:场景图。产品机会不只在“让狗坐得舒服”,而在固定、上下车、饮水、清洁和收纳的连续过程。
1. 宏观数据只能证明赛道存在
美国宠物用品市场当然具备消费基础。APPA发布的《2025 State of the Industry Report》显示,2024年美国有9400万户家庭至少拥有一只宠物,高于2023年的8200万户;其中6800万户养犬。美国宠物行业2024年支出达到1520亿美元,51%的宠物产品买家通常在线购买。
但这些数字只能说明宠物赛道大、线上渠道成熟,不能直接证明车载宠物窝值得做,更不能用于推算某个ASIN的销量。
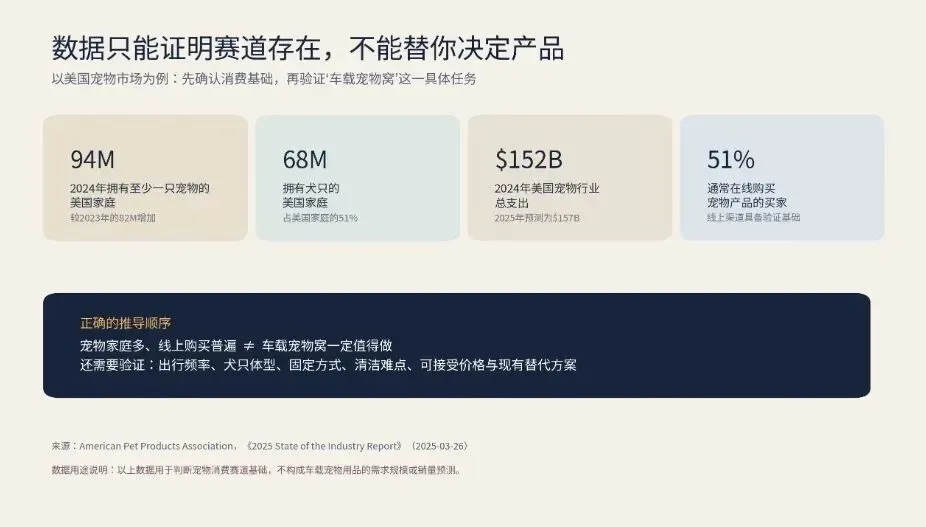
图2:数据引用图。宏观数据用于确认赛道基础,具体产品仍要回到场景、替代方案和购买意愿。
如果看到“9400万宠物家庭”就直接得出“车载宠物窝有大市场”,中间至少跳过了六个问题:养宠家庭是否开车带宠物出行、频率如何、犬只多大、现在使用什么、为什么愿意更换,以及愿意支付多少。
2. 先把“车载宠物窝”还原成完整任务
用户并不是坐进车里之后才开始使用产品。完整动线可能是:
从家里取出产品 → 搬到停车场 → 展开并固定 → 抱宠物上车 → 行驶中限制位移 → 停车后饮水和休息 → 带宠物下车 → 清理毛发或污渍 → 折叠收纳。
只看“行驶中”这一段,开发很容易把产品理解成加高侧墙、增加填充物。但沿着完整动线继续走,问题会发生变化:
填充越厚,搬运和收纳体积越大;
侧墙越软,宠物倚靠时越容易塌;
绑带越多,不一定越稳,也可能增加安装时间;
整体可机洗听起来很好,但大尺寸填充产品未必放得进家用洗衣机;
按宠物体重推荐尺寸,未必能反映犬只躺下后的身体长度;
舒适和防滑可以通过普通使用测试验证,但不能被直接写成碰撞安全。
这时,需求就不再是“做一个更厚的宠物窝”,而可能变成:为经常驾车带中小型犬出行的人,提供一个便于搬运、能够稳定安装、接触层容易拆洗的临时空间。
3. 再回Amazon看现有解法,而不是只抄差评词频
进入Amazon后,我会先建立高相关商品池,把产品按结构而不是标题关键词分组。例如:软质围栏窝、加高式宠物座椅、后排吊床、硬质航空箱或运输箱。
然后分别记录:
产品占用一个座位还是整排后座;
靠头枕带、安全带、座椅锚点还是防滑底固定;
内垫、侧墙和外套能否独立拆洗;
折叠后的真实尺寸,而不是页面上的“便携”标签;
尺码按体重、体长还是车型划分;
用户抱怨发生在安装、行驶、下车还是清洁阶段。
评论分析不能停在“尺寸、质量、安装、耐用”四个大词。比如同样是“不稳”,原因可能完全不同:底面在皮质座椅上滑动、头枕带受力后松脱、窝体宽度小于座椅导致倾斜,或者侧墙过软让用户感觉产品正在移动。
只有对比多个结构、多个ASIN,才能判断这是某个商品做工差,还是当前方案共同没有解决的问题。
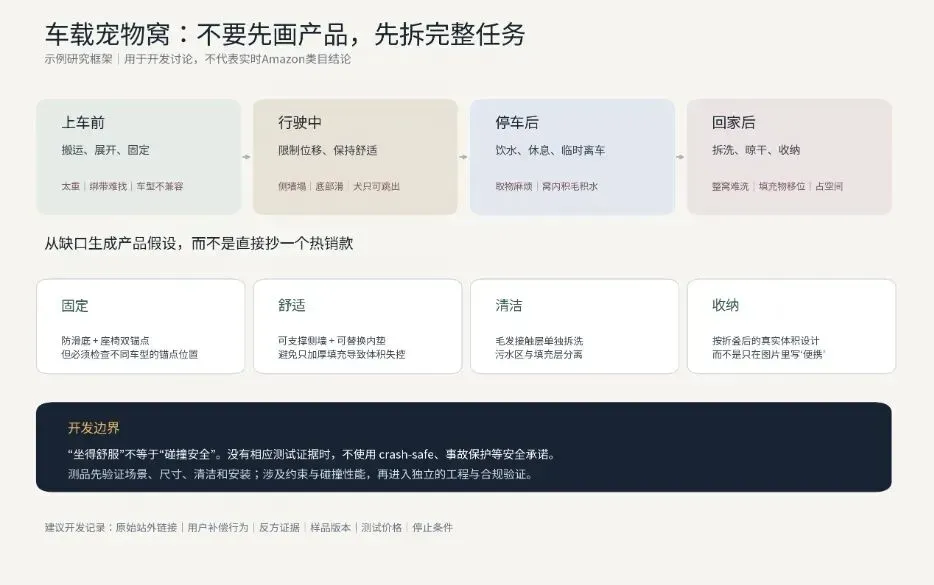
图3:产品分析图
4. 供应端的作用,是检验假设能否做出来
完成需求和现有解法分析后,我才会进入1688或联系供应商。
这一步不是寻找一款“最像目标产品”的现货,而是逐项询问:内垫是否可以独立拆卸;侧墙使用哪种支撑材料;反复折叠后能否回弹;防滑底在织物和皮质座椅上的差异;绑带、插扣和缝线的承重余量;不同车型固定点是否需要调整。
供应商说“可以做”并不等于产品假设成立。很多结构单独看都能实现,但放到一起会互相冲突。例如增加支撑板能改善侧墙塌陷,却可能提高重量和清洗难度;改成可折叠结构方便收纳,却可能削弱边缘稳定性。
所以供应端给出的不是需求证据,而是工程约束和成本边界。
PART 4
选品做到这里仍然不算完成,必须进入小批量测品
站外线索、Amazon反查和供应链评估,最终只能生成一个产品假设。开发团队可能已经把逻辑讲得很完整,但市场不会因为逻辑完整就下单。
因此,我把测品单独放成一道决策门槛。测试的目的不是快速制造销量,而是回答几个更具体的问题:
1. 用户看到场景表达后,是否愿意点击;
2. 哪个任务最能推动购买:固定、清洁、舒适还是收纳;
3. 当前价格是否足以支撑这套结构;
4. 尺寸和车型信息是否会阻碍下单;
5. 用户是在购买产品,还是只在购买折扣。
VIPON等站外Deal渠道可以用于第一轮小批量测试。做法不是一次性给出极低折扣,而是给不同批次设置清晰的测试目标,并尽量一次只改变一个变量。
例如第一批保持相同价格,对比“可拆洗内垫”和“双锚点固定”两个卖点;第二批保持主图和文案不变,测试两个接近的价格区间;第三批再观察不同犬只尺寸或车型场景的点击与成交差异。
站外数据也不能只看订单数。更有用的是观察完整漏斗:
有曝光、少点击:场景或首屏表达可能不成立;
有点击、少领码:优惠力度、价格认知或人群匹配需要检查;
领码多、下单少:Listing信任、尺寸说明或结算价格可能存在阻力;
下单正常、退货集中:产品结构、适配或预期管理存在问题;
大折扣能卖、接近日常价就停止:证明的是促销敏感,而不是正常价格需求。
测品之前还应写好停止条件。例如两轮素材和页面修正后,目标场景依旧无法形成有效点击;或者点击正常,但在接近目标售价时始终没有购买意愿;又或者退货原因集中在无法通过小改解决的结构问题。满足停止条件时,应当回到需求假设,而不是继续加大折扣和广告预算。
这也是我认为站外测品最重要的价值:它不一定帮我们找到爆款,但可以让一个错误方向更早暴露。
PART 5
我现在怎样记录一条选品线索?
为了避免复盘时只剩下一句“当时感觉不错”,我会要求每条线索至少保留以下内容:
1. 原始证据
包括原始URL、平台、查询词、采集日期、用户原话的简要摘录,以及内容属于求助、抱怨、补偿行为还是反方证据。AI可以协助归类和摘要,但重要判断必须回到原始内容复核。
2. 任务与限制
用户在什么场景完成什么任务,受到哪些限制,现有方法为什么不顺。这里暂时不写具体产品名称,避免开发过早收窄答案。
3. 现有替代方案
用户现在如何解决,包括不购买、减少使用、用其他物品替代或者接受额外动作。替代方案越便宜、越顺手,新产品需要提供的价值就越高。
4. Amazon市场轮廓
记录高相关商品的结构分组、价格段、评分评论、上架时间和共同卖点。数据用于描述相关商品池,不把单个头部ASIN当作整个市场。
5. 产品假设与反方证据
每个假设都要同时写支持证据和反方证据。例如用户需要容易清洗,但可拆结构可能增加缝隙、成本和安装步骤。只记录支持材料,最终很容易变成替既定方案找理由。
6. 下一步最便宜的验证
可能是访谈、纸板模型、供应商样品、页面概念测试,也可能是VIPON小批量Deal。验证动作越靠前、成本越低,就越容易在团队已经投入感情之前否定错误方向。
PART 6
这套方法有哪些局限?
第一,站外讨论存在人群偏差。愿意发帖的人可能问题更严重,也可能比普通消费者更热衷表达,不能把帖子数量直接换算成市场规模。
第二,AI能够提高采集、聚类和整理速度,但它也可能合并不同语境、遗漏反例,甚至把高频表达误判成购买需求。AI日报只能提供线索,不应代替开发判断。
第三,小批量Deal验证的是特定人群、页面和价格组合,不等于自然搜索环境下的长期销量。站外测试表现好,还需要回到正常售价、广告成本、退货率和复购逻辑继续验证。
第四,汽车用品和宠物用品都可能涉及安全宣称。车载宠物窝能够做到更稳、更易清洁,不代表具备碰撞保护能力;手机支架减少手持操作,也不能被包装成绝对安全驾驶保证。没有相应测试和证据,就不应扩大宣称。
END
我不再要求日报告诉我“应该开哪款产品”
重新整理流程后,我对选品工具的期待反而降低了。
我不再希望一份数据报告直接给出“应该开发什么”,而是希望它把决策过程保留下来:用户正在完成什么任务,卡在哪一步,目前怎样凑合,现有商品解决了什么、还缺什么,供应端能否实现,以及最便宜的下一步验证是什么。
站内数据告诉我们什么已经成交,站外线索帮助我们看到尚未被产品化的任务,小批量测品则用真实购买行为检查团队的判断。