不用学了,AI 做视频这句话就够了
 66
之前很多人让我出教程:怎么让 claude 做 ppt
怎么让 claude 做视频
我一直没写。
我看过很多这方面的文章和教程视频,一般是推荐各种 GitHub 仓库或者 skills。
这些工具本身没什么问题,也都做得很好。
但在我看来,这些教程最大的问题就是它们不落地,无法进入生产环境。
原因是:其实每个人想要的视频是不一样的:
如果你是一名老师,你可能要的是一个纸片风格的视频,用更加生动的细节去展示知识。
如果你是一个口播博主,你要的是真人感的视频,让用户在视频里面感受你传递出来的真实感和信任感。
如果你是一名科普博主,你要的是真实素材+真人视频+科普动画的混合,才能生动地展示知识点。
这就意味着,其实没有一种方法可以满足绝大多数人,因为大多数人的需求本身就是不同的。
特别是如果你是做自媒体,变现方向还不同:
有的是靠播放量来变现;
有的靠直播带货来变现;
有的是靠引流到私域来变现。
大家都需要短视频来引流,但是大家的视频的第一目的是不同的。
但这个情况现在变了。
Claude 出了 5.5 之后,我自己简单尝试了一下发现,用 AI 做视频教程可能已经有了“版本答案”,或者说,你再也不需要去看任何所谓的 AI 视频教程了,因为真的一句话就可以搞定。
那我一共给 AI 提供了什么呢?
一共就 3 个东西:
1.我的声音
2.我的照片
3.一个同行做好的参考视频
当然你得给他提供图生视频的大模型api 或者数字的 api嘛,所以我还给了他我的 liblib (简单理解就是上面有很多的视频和图片模型可以使用)账号,我跟他讲要用 liblib 上面的数字人模型。
一句话做视频:完整教程
所以,怎么用一句话让 claude 帮我做视频?
完整教程如下:
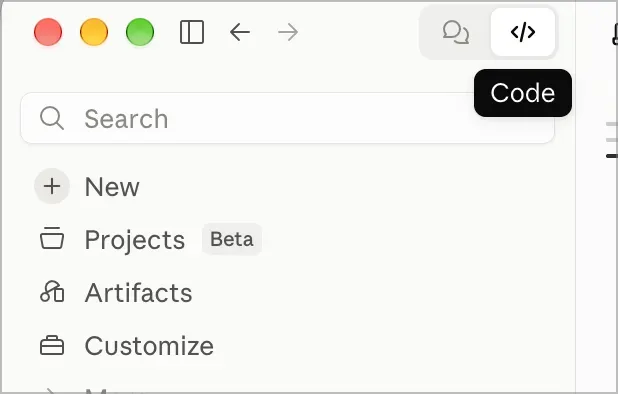
打开 claude,切换成 code 模式(需要付费会员,免费版没有这个模式)。
上传一段你喜欢的、想要模仿的视频,这个视频你可以从抖音、油管或者 B 站上面搜。
然后输入这个提示词:
认真看一下我上传给你的视频,接下来你要对标这个视频,做出一个同样高质量的视频。
一个画面只放一个重点,字要大;语速正常,不要加速。
需要的素材你自己想办法解决,比如去找免费可商用的素材。
下面是我的文案,现在开始制作吧。
文案:xxx
就是这么简单~
给个标准答案,然后照着答案抄就可以了,不需要瞎指挥,因为我们都不如 ai 聪明。
你不用教它怎么做,只要告诉它什么叫“好”就行。
这就是现在用 ai 的核心技巧:告诉 ai 你想要的结果,越直观越好,不要说:我要五彩斑斓的黑,而是直接给一个五彩斑斓的黑给ai 就好了。
第一次跑的时候,它可能会让你装几个软件(比如处理视频的 ffmpeg),一路点允许就行。
如果你是要做真人视频,那你需要同步上传你的声音(10 秒以上、安静环境里录的就行),你的一张背景干净的正脸照片。
然后打开谷歌浏览器,登录你的 liblib账号(如果你有比如 OpenRouter 的 api,直接给 api 也可以。)
提示词就可以改为:
认真看一下我上传给你的视频,接下来你要对标这个视频,做出一个同样高质量的视频。
一个画面只放一个重点,字要大;语速正常,不要加速。
需要的素材你自己想办法解决,比如去找免费可商用的素材。
我的照片和声音已经上传给你了。
如果需要作图或者做视频,或者做我的数字人视频,我已经在谷歌浏览器上面登录好了我的 liblib 账号。
下面是我的文案,现在开始制作吧。
文案:xxx
另外提醒一句:AI 做的视频发到抖音这些平台,记得按平台要求标注“AI 生成”。
60 分的问题
最后让我们重新回看一下这个视频。
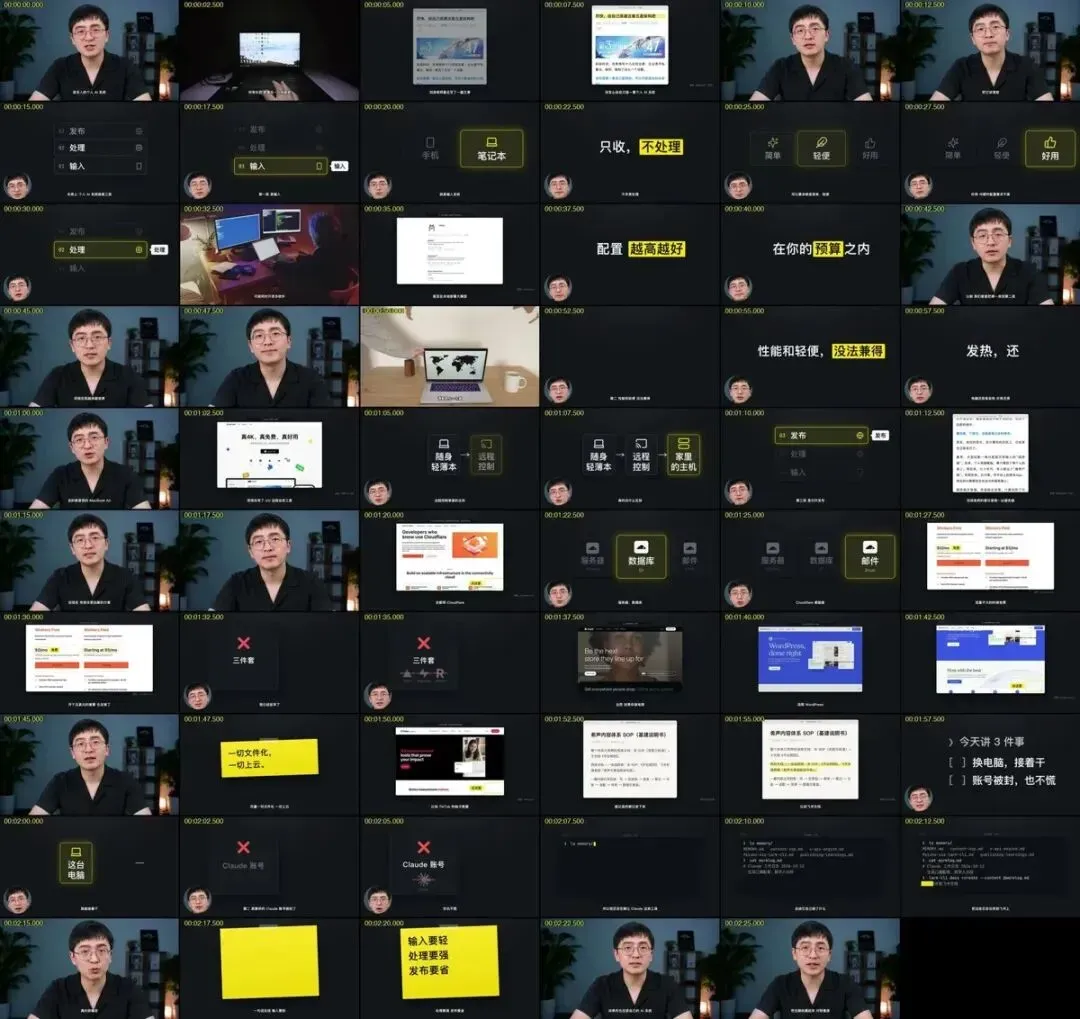
如果我心里的满分是 100 分的话,目前只能勉强做到 60 分吧,其实还是有挺多问题的。
比如说,你看过很多优质视频,就知道它们的内容不会在一个画面上放太多的文字。
而很多所谓的用 AI 做视频的 skills 做出的视频,都会有这个问题,就是恨不得在一个页面上塞太多的字,这是不考虑用户体验的。
我自己的第一版也是这样,下面是改之前和改之后的对比:
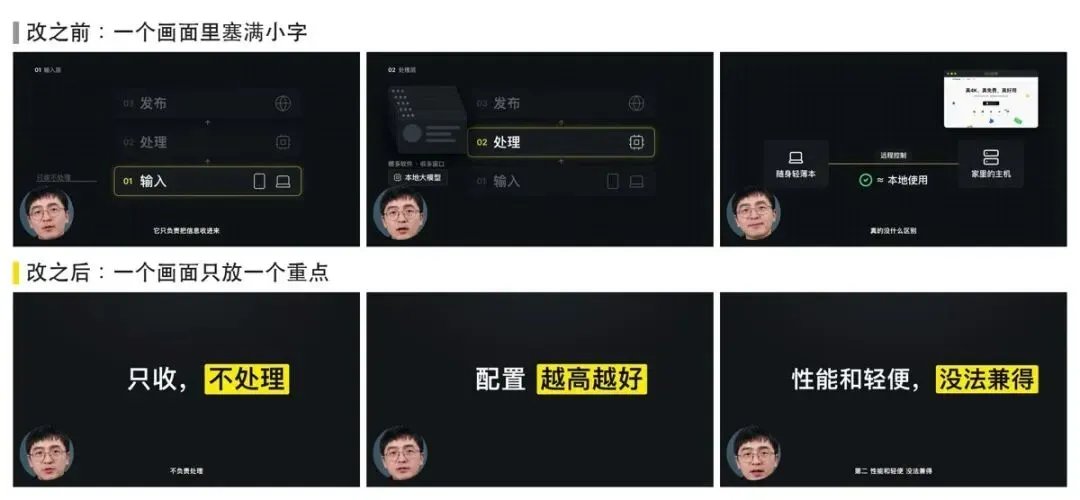
所以,目前 AI 一句话做视频距离真正优质的视频还是有一段距离的。
但起码对任何一个普通人来讲,你确实真的可以通过一句话就做出 60 分的视频,但是 90 分的视频还是需要花一定时间打磨的。
当然,如果你以前剪过这种视频,那我相信当你看完这些东西,你其实就已经知道怎么从 60 分走到 90 分了
从 60 分到 90 分
如果你要继续精进,想从 60 分做到 90 分,下面是我提供的优化思路:
1.将你的对标视频内容拆分成不同的模块,特别是一些动效或者元素,可以拆分成不同的组件库,这样让 AI 可以自由地调用。
就像搭乐高,需要哪块拿哪块。
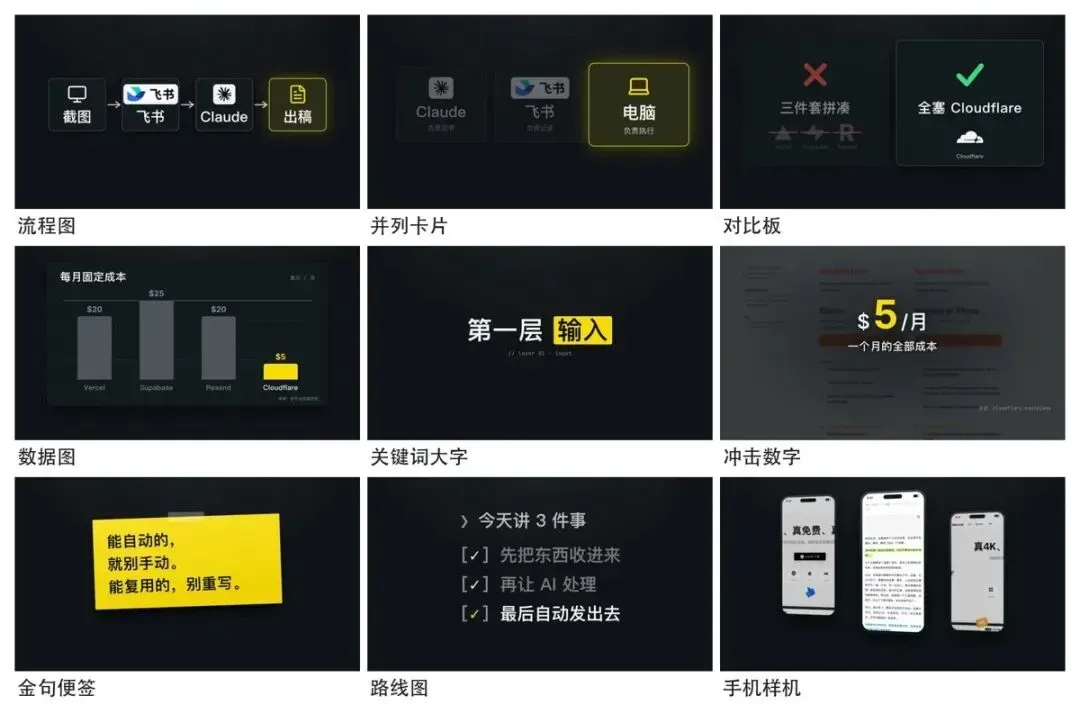
▲ 我现在的组件库(一部分)
2.不同的元素模块之间要有一个共同的设计规范。颜色、字体、卡片样式统一了,拼在一起才像同一个人做的。
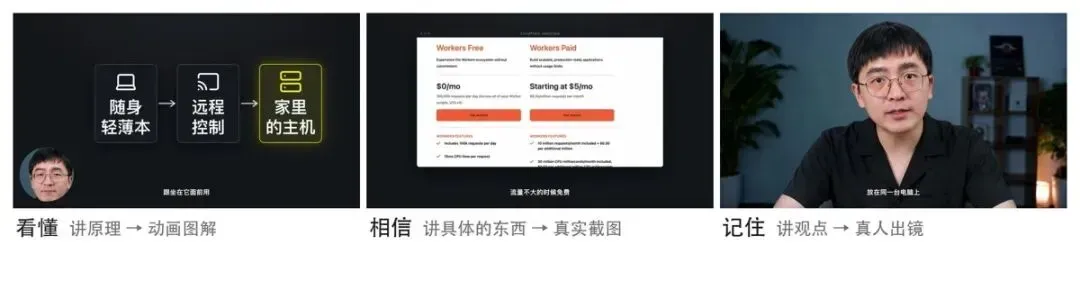
3.先给每句话分个类:要观众看懂的,用动画图解;要观众相信的(具体的产品、网站、人物),放真实截图;要观众记住的观点,让人出镜。
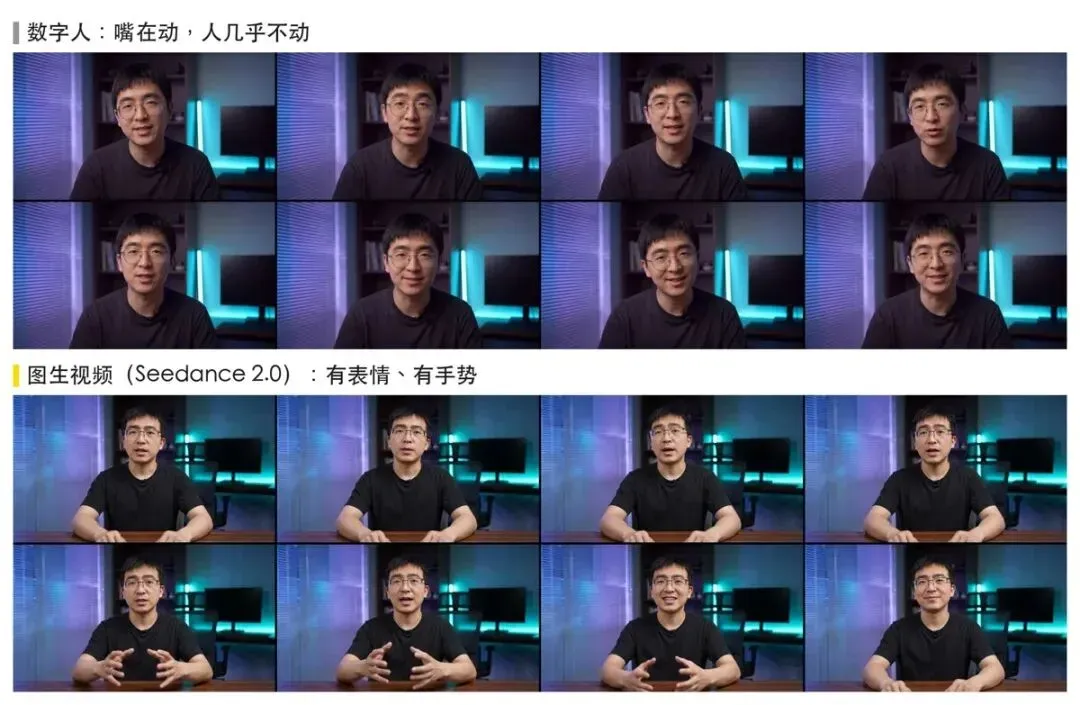
4.还有,数字人模式下的人依然会有僵硬的问题,终极解法就是得用 Seedance 2.0 或 2.5 这类图生视频模型来解决。
因为数字人是“声音拽着嘴动”,嘴在动,人几乎不动;图生视频是让模型自己“演”,有表情、有手势。2.5 整体更强、单条更长,但我实测中文口播的嘴型 2.0 更自然,这个大家就可以按需求选。
5.另外,要多给些真实图片作为参考图。
然后挑选最好的一两张图,先让 AI 用你真人照片做一张“人物设定图”,再拿去生成视频,会像本人很多。
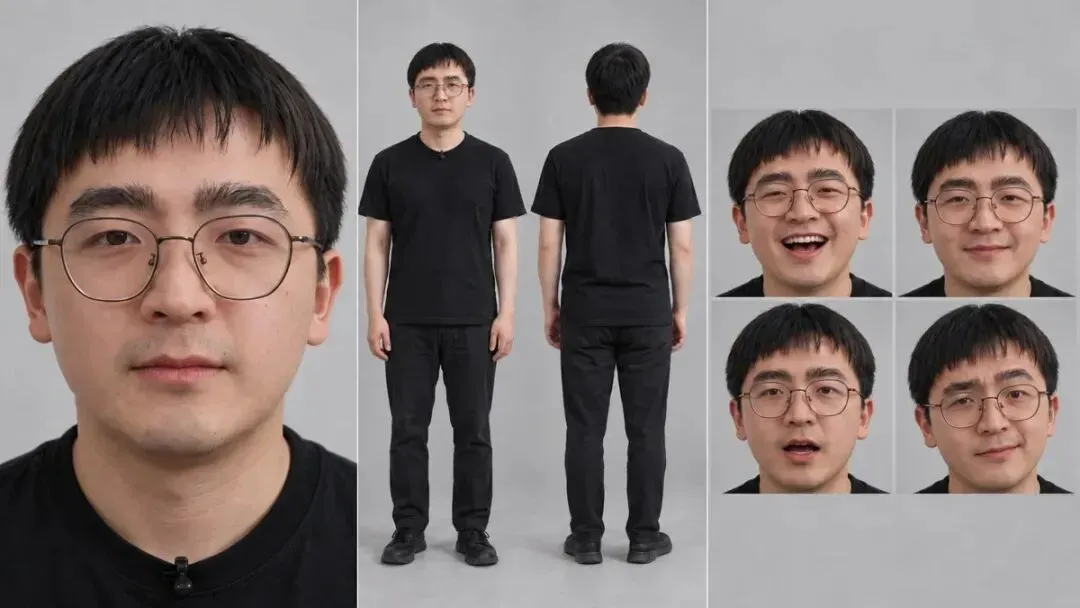
▲ 用两张真人照片做出来的人物设定图
视频迭代的一些技巧
后来我又做了几条片子,流程大概是:
先根据文案倒推内容:每个画面要讲什么,观众看完要记住哪一两个画面。 拆模块:每句话说出来的时候,观众该看见什么。 先跑一版不花钱的草稿:代码画面、占位素材、AI 临时配音。 在草稿上定大方向,因为这时候改最便宜,而且这个时候会有些视频灵感可以补充进去。 最后才花钱调用作图或者做视频的模型。
我还开了好几个 Claude 窗口分工:导演、出镜、素材、动画、挑毛病,像一个小剧组。
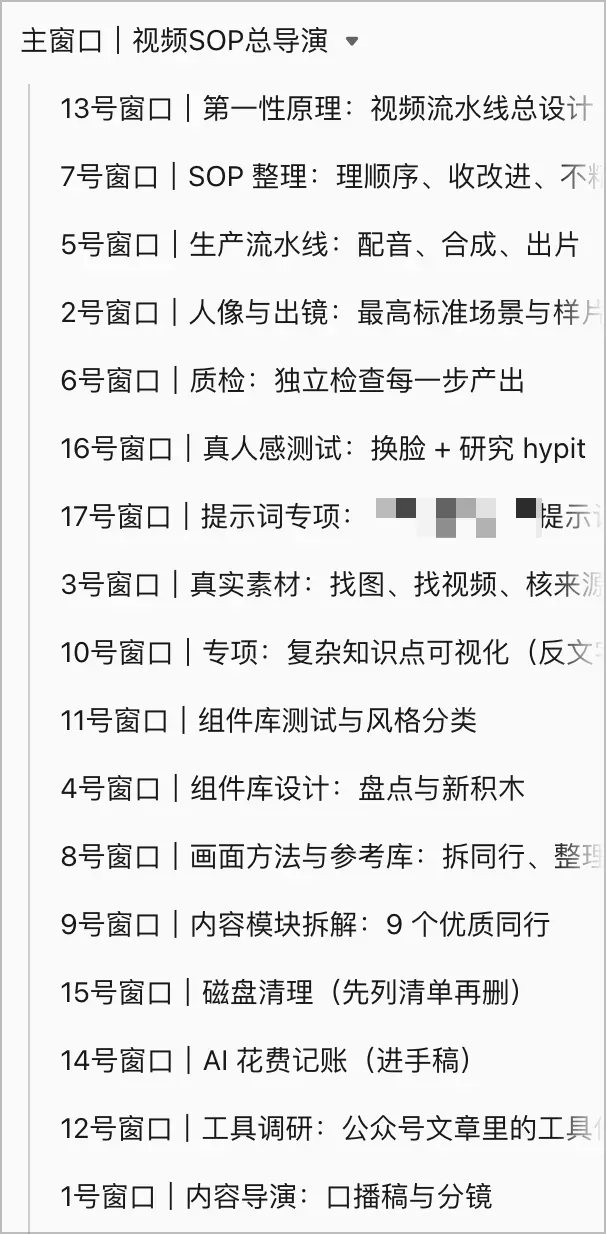
现在的答案
这是我迭代出来的最新一条:
3 分钟左右,花了 30 多块,主要花在真人出镜上。
又做了几点优化:
用自己的真声录口播。 真人出镜只占两成左右。 竖版为主,横版发 B 站和 YouTube。
说实话,现在的效果我也不太满意。
人脸还不够真,动作也还有点僵化不灵活,还有很大的进步空间。
最后提醒一下,一个视频的好坏,其实在我看来,内容,也就是文案,比重是最大的,至少 60%,画面,动效,声音等,其实都不是最重要的,只是辅助的表现形式。
所以不要舍本逐末哦~