拆解极目数据MCP选品原理

 161
选品基本准则
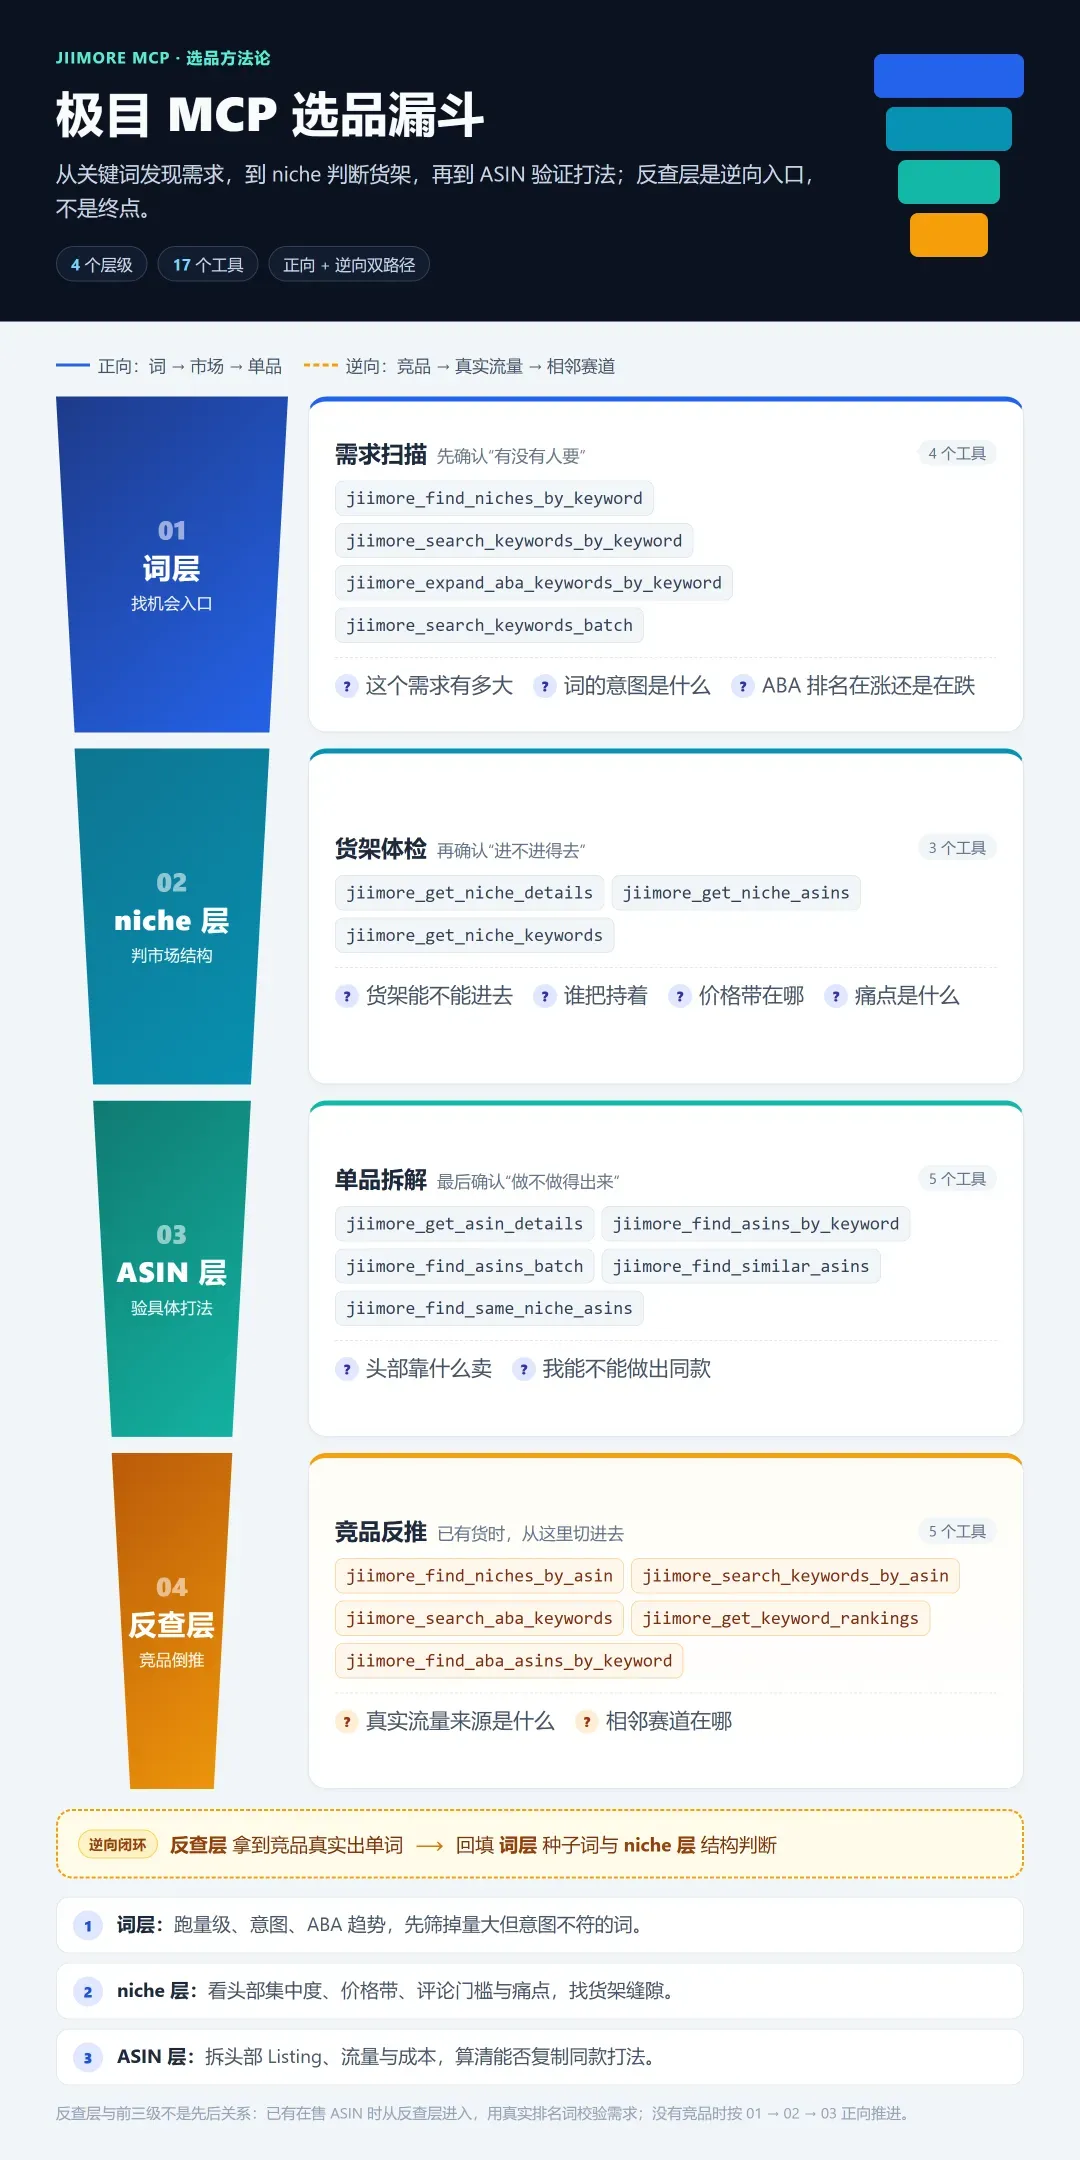
选品要把个人主观“感觉不错可以做”变成“四道可用数据验证的闸门”,极目数据 MCP 的价值在于,它的底层数据逻辑是搜索词 → 市场→ ASIN 三层可量化的数据链。用它来选品,整个流程就是一条漏斗,一个类目用户搜索词排名Top20会形成一个市场,市场下对应有相应产品。我们可以利用这三道数据链,加上最后一道由竞品反查市场需求,形成完整闭环。
选品五步法
第 1 步:开候选关键词池,可以选赛道的2-5个关键词
用这些关键词,大模型会自动调用极目数据MCP按关键词搜市场,文中用到的关键词有:dog toys, dog chew toys, durable dog toys。
第一道粗筛,不符合条件市场去掉
市场90天销量 < 5,000 → 直接砍(撑不起一个 SKU)市场360天退货率> 8% → 砍(售后会吃掉利润)产品均价 < $8 且 cpc中位值 > $1.2 → 砍(客单价撑不住广告)周搜索转化率 < 3% → 标记“需求存在但不成交”,留观
第 2 步:判红海,看四个结构指标 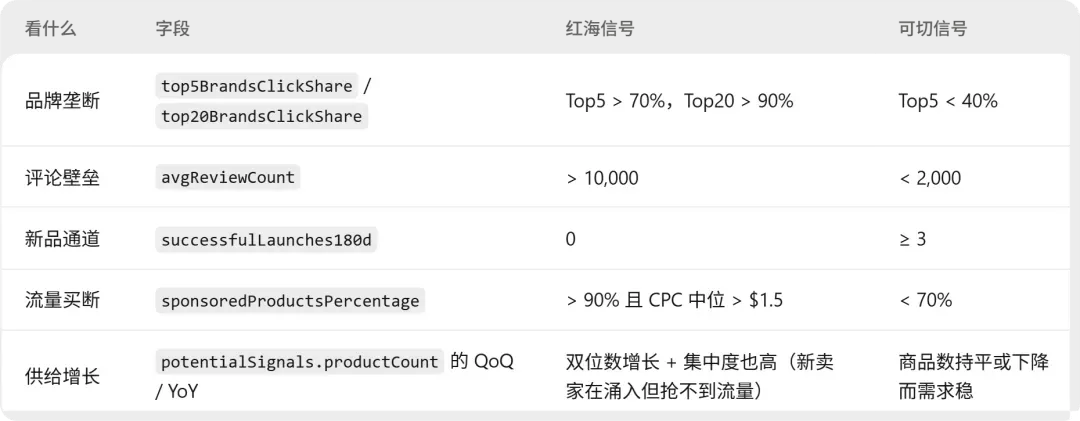
笔者用到 dog toys 就是典型的“可切但难做”:Top5 品牌 36%、Top20 71%(不算垄断),但 93% 广告位 + 平均评论 1.79 万 + 180 天只有 4 个成功新品——机会有,但门票很贵。
第 3 步:找差异化切口,看差评而不是看好评
极目数据市场详情MCP接口,会返回相应市场的正负面评价以及摘要,这数据对于选品是有价值,可以真实反馈产品好在哪,缺陷是什么,缺陷是否是致命不可修复? 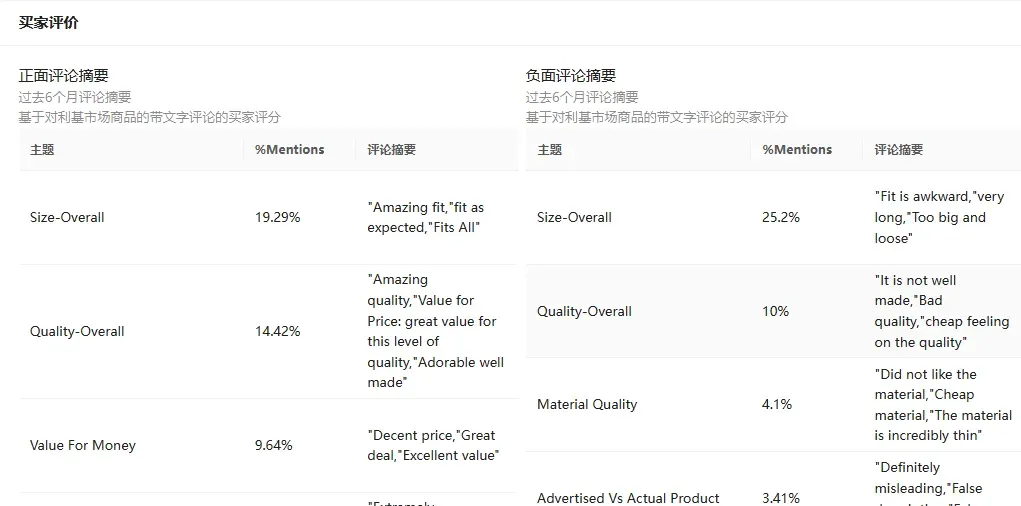
筛选规则:
某个负向主题占比 > 20% → 这是结构性缺陷,值得开模 10%–20% → 可以做改款/文案层差异化 正向主题占比高但负向也高(比如 dog toys里耐用正向 15%、负向 32.8%)→ 说明没人做对,这是最肥的位置
第 4 步:回到词层做交叉验证
查看市场关键词 — 看 niche 内部词群的 90 天点击/份额,确认流量结构用市场关键词,批量查询关键词指标 — 看核心词的精确搜索量、CPC、cpr、aba排名变化拓长尾,判断需求表达是否分散(分散 = 可以打长尾规避大词)
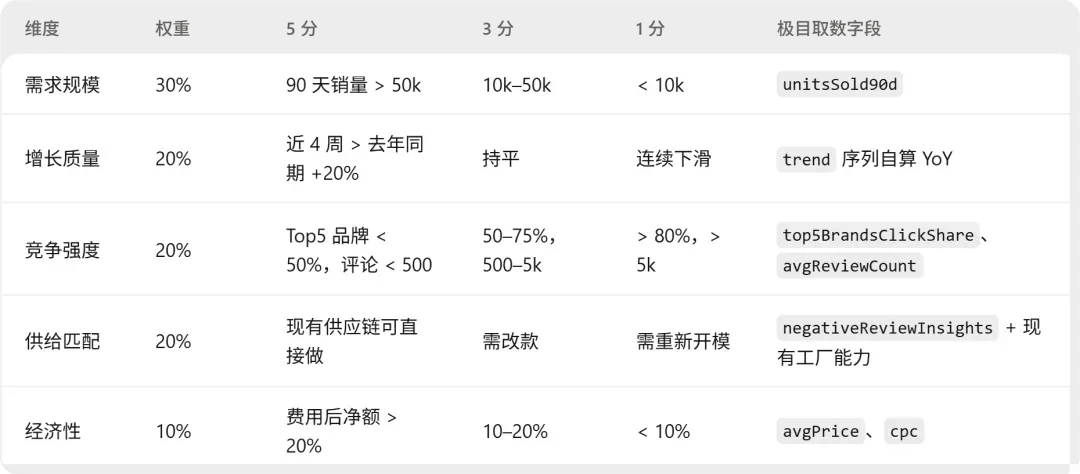
算例(用 dog toys 真实数据):
需求 5(90 天 44.7 万单)×30% = 1.5
增长 3(全年区间震荡,无趋势性增长)×20% = 0.6
竞争 2(评论壁垒 1.79 万、广告 93%)×20% = 0.4
供给 2–3(耐咬需开模)×20% = 0.4
经济性 2(客单 $12、CPC 中位 $1.29)×10% = 0.2
总分 3.1,有待观察。
改切它下面的 stuffed animal for dog(10 个商品 / 4 个品牌)——同一人群、同一场景、供给缺口明确(详细报告这里就不雷同补充)。这就是“红海结论和细分结论互相解释”。
市场选出来了,下一步就是查看市场产品,可以让大模型继续往下跑,给你推荐相应产品并且出选品决策表。