可交接、可重复、可验证:亚马逊团队AI落地的三个条件
 141
可交接、可重复、可验证:
亚马逊团队 AI 落地的三个条件
亚马逊团队用 AI,大部分都是这样子:工具换了三轮,会用的还是那几个人。报表出得更快了,判断还是在等老板。文案十分钟能出一版,改它的人反而更累。效率上去了,能力没上去。
原因在于 AI 在多数团队里被当成了个人工具,而不是组织流程。个人工具提高单点速度,组织流程沉淀可复用能力。这两件事长得很像,结果完全不同:前者跟着人走,后者留在公司。
区分它们只需要三个问题。同一个任务,换一个人做,能不能跑出同样的结果?同样的输入,跑两次,结论的结构是否一致?每一条判断,能不能追到具体的数据来源?
三条对应三个条件:可交接、可重复、可验证。
可交接:方法得从人脑里搬出来
判断很简单:一个新人进公司,你怎么教他做选品?你发给他什么文档?你手上只要有这个东西,它就是你的选品方法论。拿不出来,公司就没有方法论,只有几个会做的人。
数据分散,让方法没法被写成文档。
一个 SKU 从想法到上架,要过市场端、竞品端、评论端、供应链端、广告端、财务端等几类数据,散在卖家精灵、ERP、后台、飞书、Excel 和几个人的微信收藏里。
分散的直接代价不是找得慢,是每一次判断都要重新收集一遍证据。于是判断只能由最有经验的那个人做,因为只有他知道去哪里找、哪些数据可信。方法寄生在一个人的记忆和路径里,没法单独拿出来交给别人。
SOP 传动作,不传判断。
同一句「看转化率决定要不要加预算」,在老运营脑子里是一套完整判断链:样本量够不够、转化来自哪个位置、加预算会不会带到不相关的位置、季节性在不在。
在新人脑子里就是「转化率高于多少加」。判断的核心不是动作顺序,是指标和阈值——哪个指标看、什么值算高、什么情况不判。这些东西对老运营太显然,所以从来没被写下来。
打法复制不了,因为打法从来不是一套动作。 爆款复盘出「我们做对了三件事」,下一个品照着做做不出来。
因为让那个爆款成功的不是三件事,是三件事背后的条件:当时竞争度多少、价格带竞品结构什么样、人群痛点靠什么信号识别、预算节奏为什么这么排。条件没被记录,「三件事」离开那个具体的品就是空话。
AI 提效了,但没有变成资产。 团队已经在用 AI 写 Listing、翻译评论、做图。问一句:这半年,公司多了什么?有没有多出一份让新人少走三个月弯路的检查表,一个不依赖某个人的判断流程,而不是多出几个会用 AI 的人。如果没有,AI 投入就是一次性的效率消耗。
原因是提示词这种形态本身沉淀不下来,它是写给人看的一段话,每次复制粘贴都要重调,而且它沿着大模型自己的理解走,不沿着你的规矩走。提示词解决「这一次怎么让 AI 干」,不解决「以后每一次都按我的规矩干」。
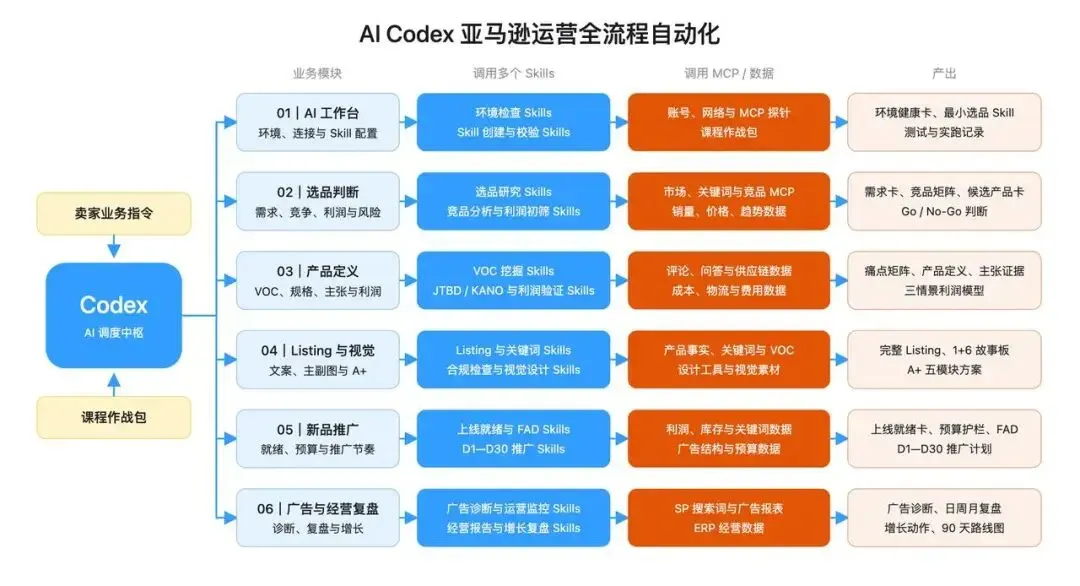
卧虎老师《AI Codex 亚马逊运营全流程自动化》这门课,讲 Codex 的第一层作用,就是给数据建一个唯一入口:选品产生的结果直接交付到 Listing 打造,标题五点图片再交付到广告初始化,之后接报表分析。链和散的区别在于,链上每一环都知道上一环给了什么、自己该给下一环什么。
举个具体例子。选品阶段锁定了三个对标 ASIN。到了 Listing,它们是抓取竞品标题五点的来源;到了评论分析,是抓取对象;到了关键词,是反查入口;到了广告,是投放参照。散的状态下,这四件事是四个人分别去问「我们对标的是哪几个 ASIN」。链的状态下,它自动成为下一环的输入。
还有一个容易忽略的设置:项目要隔离。选品一个项目、Listing 一个项目、评论分析一个项目,分开建、分别调用。不只是文件堆一起会乱,更重要的是不同环节规则不一样,混在一起互相污染。项目级规则高于用户级,因为项目级针对的是特定场景。
可重复:同一份输入,跑出同一个骨架
方法写成文档之后会撞上第二个问题:文档是死的,执行是活的。同一个文档两个人执行,结论可能相差很远,这不是执行不力。
可重复要成立,方法里必须有两样东西:参数和判断标准。参数是方法论里一定有的指标,判断标准是阈值和范围。
同时可重复还有前提:缺失时不许补。 AI 在信息缺失时的默认行为是补全,它会把不存在的竞品参数写得像真的,而且比有据可查的还流畅,所以必须配兜底机制。
一种是数据源降级链:优先读主数据源,不可用就跳下一个,最后落到本地报表;都没有就阻断,不做判断,并且提示你去补什么,而不是干等。另一种是门禁:写 Listing 之前检查必填字段,缺字段主动追问,不许自己编。
写完之后过一组硬性校验,比如违禁词、竞品品牌词、必埋关键词、标题字符数、描述字符数、后台搜索词字节数,以及平台对商品事实、可回答性、辨识度、预期管理、语义一致性的要求等等。校验不通就重写,几轮不过就转人工。
为什么这些门禁绕不过去?因为不严格限制门禁,AI 就会产生幻觉,给你瞎编一个竞品,让你沿着错的方向往前走。
对照你自己的公司想一想:之前有没有出现过「AI 写得挺好,上架后发现参数错了」的情况?如果有,那不是 AI 的问题,是没门禁。
SOP 升级成 Skill,才是可重复的实现路径。 Skill 的定义是:把你涉及的工具、脚本、模板、输入输出、工作流程全都定死。定死初听像限制,其实是保护。
定死意味着可重复,同一份输入跑出来的结构一样;意味着可交接,换个人跑结果不会崩;意味着可优化,出了问题知道改哪一条规则,而不是重新调提示词碰运气。
也就是说:提示词把大模型的能力变成一次性的发挥,Skill 把大模型的能力转化成可以复用、可以按我们的规则办事的操作流程。
可验证:每一句结论,追得到数据源
第三道门最少人提,但它决定前两道是真是假。标准是:这个结论的每一句,能不能指回一条具体的、真实的、可查的数据。
所以要把「看着像不像」换成「有没有依据」。 很多人对 AI 输出的信任度取决于看着像不像,这是很危险的标准,因为 AI 最擅长的就是像。
一旦团队习惯这套判断,审稿的性质就变了:以前是「我看着有点不对,你再改改」,现在是「这一句的 Evidence 在哪」。前者是审美,无法交接;后者是条件,可以交接。
同时数据同样要经得起追,数据源也要交叉验证,单一数据源会导致词不全、结论偏。降级链的意义也在这里:它规定了数据不全时系统怎么走,而不是让模型自己发挥。
这个规定本身就是凭据——你可以回头查,这个结论是在主数据源拿到的,还是在本地报表拿到的,还是根本没拿到所以被阻断了。
因此三条为什么是递进的?
就是不能交接的东西无法验证,验证的前提是另一个人能复现;不能验证的东西无法重复,重复一个说不清来源的结论,只是把同一个错误跑了两遍,而且越跑越熟练。
很多公司只做了第一条,买了工具、写了几份文档,就觉得「我们 AI 化了」,半年后再看,能拿出来的东西没有增加。
这就是三个条件的全部:方法从人脑里搬出来,用参数和阈值把它变成可重复的规则,再给每条结论挂上来源。
三条同时成立才算数,缺一条,另外两条基本是假的。